
Qué queda de un archivo generado por IA cuando le quitas la metadata
Un estudio de caso sobre la eliminación de procedencia C2PA/JUMBF y su detección en plataformas.
Este documento es un informe técnico de investigación, no un tutorial operativo. Su finalidad es analizar la robustez del estándar C2PA como mecanismo de marcado de procedencia, en el contexto del artículo 50 del Reglamento Europeo de Inteligencia Artificial (AI Act).
No se autoriza, promueve ni facilita el uso de la información aquí contenida para:
- Eludir obligaciones legales de marcado, divulgación o transparencia sobre contenido generado por IA, presentes o futuras, en cualquier jurisdicción.
- Vulnerar los términos de servicio de plataformas de vídeo, redes sociales, motores de búsqueda u otros servicios digitales que exigen la declaración del uso de IA.
- Engañar, suplantar o manipular a personas mediante la eliminación de señales de procedencia en contenido sintético.
- Infringir derechos de autor, derechos de imagen o cualquier otro derecho de terceros.
- Cometer fraude, desinformación o cualquier actividad ilícita tipificada en el Código Penal español o en la normativa europea aplicable.
El experimento descrito se realizó sobre archivos propios, con fines exclusivamente académicos y de reproducibilidad, y bajo el principio de divulgación responsable. Los archivos, hashes, cadenas y nombres de canción citados son ficticios o han sido anonimizados.
El autor no asume responsabilidad alguna por el uso indebido que terceros puedan hacer de la información publicada. La reproducción total o parcial de este contenido con fines distintos a los aquí declarados queda fuera del propósito del documento y es responsabilidad exclusiva de quien la realice.
Si su intención es eludir una obligación legal o engañar a una plataforma o a un usuario, este documento no es para usted. Deténgase aquí.
Resumen
El estándar C2PA, incorporado al artículo 50 del Reglamento Europeo de Inteligencia Artificial como mecanismo de marcado legible por máquina, sitúa la procedencia del contenido generado por IA dentro de la metadata embebida del archivo. Este artículo examina empíricamente la robustez de ese mecanismo mediante la construcción de un pipeline binario de análisis, limpieza y verificación aplicado sobre un JPEG (93.474 B) y un MP3 (5.380.883 B) con marcas de procedencia, y la posterior publicación del MP4 resultante en una plataforma de vídeo.
El estudio mide tres variables: (1) la cantidad y tipo de metadata de procedencia presente en los archivos originales; (2) la integridad estructural del contenido tras la eliminación binaria de esos bloques; y (3) el comportamiento de la plataforma ante un archivo sin C2PA. Los resultados muestran que la eliminación de 21.892 B (JPEG) y 22.259 B (MP3) de metadata no altera el contenido audiovisual ni la validez estructural de los archivos, y que en el caso observado la plataforma no aplicó la etiqueta automática de contenido IA al contenido publicado.
Se discuten las implicaciones para la eficacia del estándar y se identifican las limitaciones del estudio: una sola plataforma, un solo formato de publicación, una sola cuenta y ausencia de grupo de control.
El problema de la procedencia
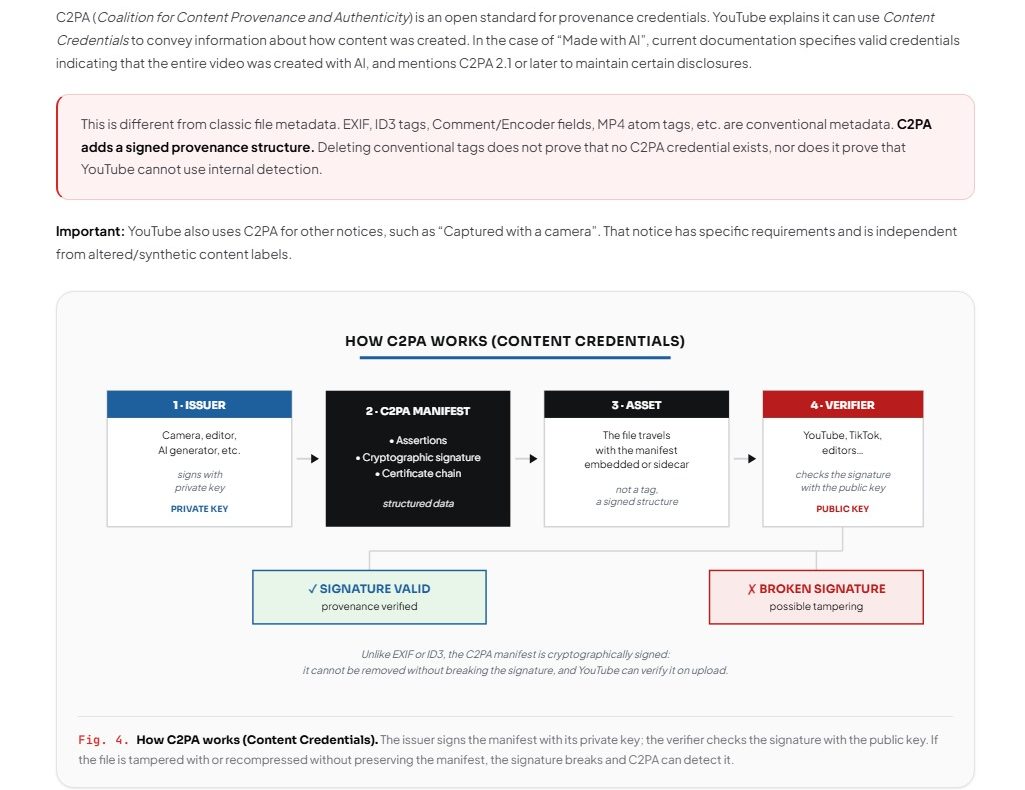
En febrero de 2021, un consorcio internacional de empresas tecnológicas y medios de comunicación fundó la Coalition for Content Provenance and Authenticity (C2PA), una organización de estándares cuyo objetivo es crear un mecanismo abierto para verificar el origen y el historial de modificaciones de un contenido digital. La coalición ha crecido hasta superar los 6.000 miembros y afiliados, incluyendo grandes tecnológicas y grupos de comunicación internacionales. El estándar C2PA se articula en torno a un manifest store firmado criptográficamente que se embebe en el propio archivo, describiendo la cadena de custodia del contenido desde su creación hasta su publicación.
La elección del contenedor no es neutra. C2PA utiliza el JPEG Universal Metadata Box Format (JUMBF), definido en el estándar ISO/IEC 19566-5:2023, como formato universal para embeber metadata en cualquier archivo JPEG basado en cajas. En el caso específico de JPEG, el manifest store se inserta como datos dentro de un segmento marcador APP11, conforme a la especificación JPEG XT (ISO/IEC 18477-3). Dado que un único segmento APP11 no puede superar los 64 KB, es habitual que se requieran múltiples segmentos contiguos.
El resultado práctico es que la procedencia de un archivo generado por IA —si fue creado con un generador de imágenes, un generador de audio o cualquier otra herramienta— vive dentro de la metadata del archivo, no dentro del contenido audiovisual propiamente dicho.
La dimensión regulatoria
La Unión Europea ha incorporado esta lógica al artículo 50 del Reglamento de Inteligencia Artificial (AI Act), cuyas obligaciones de transparencia entran en vigor el 2 de agosto de 2026. El artículo 50(2) establece que los proveedores de sistemas de IA generativa deben asegurar que sus resultados sean marcados en un formato legible por máquina y permanezcan detectables como generados artificialmente.
La Comisión Europea ha precisado que «legible por máquina» significa que la marca debe estar estructurada de modo que las aplicaciones de software puedan identificarla, reconocerla y extraerla sin intervención humana. Las directrices publicadas en julio de 2026 subrayan además que los mecanismos de detección deben identificar si el contenido ha sido generado o manipulado por IA, típicamente mediante marcadores técnicos o firmas que verifican su origen.
En paralelo, las principales plataformas de distribución de contenido han implementado sistemas de etiquetado que reconocen automáticamente el contenido generado por IA cuando el archivo contiene metadata C2PA 2.1 o superior que indique que el contenido fue creado íntegramente con IA. Desde mediados de 2026, varias de estas plataformas han movido estas etiquetas a posiciones más prominentes y han comenzado a aplicar señales internas de detección automática.
La pregunta de investigación
El estándar C2PA y las obligaciones del AI Act comparten una premisa fundamental: que la procedencia del contenido puede verificarse de forma fiable a través de la metadata embebida. Pero esta premisa descansa sobre una propiedad que rara vez se examina empíricamente: la metadata es eliminable sin alterar el contenido.
La pregunta que articula esta investigación es la siguiente: ¿Qué ocurre cuando la metadata de procedencia desaparece pero el contenido permanece intacto? Más concretamente: si un archivo generado por IA es sometido a un proceso de eliminación binaria de sus bloques de metadata C2PA/JUMBF, ¿sigue siendo estructuralmente válido? ¿Y cómo responde la plataforma de destino ante un archivo sin señales de procedencia?
Relevancia y alcance
La respuesta a esta pregunta tiene implicaciones directas para la eficacia del marco regulatorio europeo. Si la marca legible por máquina es trivialmente eliminable sin dañar el contenido, entonces la obligación del artículo 50(2) depende de que nadie la quite, no de que sea difícil quitarla. Esto no invalida el estándar, pero sí acota su alcance: C2PA funciona como un mecanismo de confianza para actores cooperativos, no como un sistema de detección resistente a la manipulación.
Este artículo presenta un estudio de caso empírico. Se analiza un JPEG de 93.474 bytes y un MP3 de 5.380.883 bytes con marcas de procedencia conocidas, se documenta la estructura binaria de sus bloques de metadata, se describe un pipeline de eliminación sin recodificación, y se observa el comportamiento de una plataforma de vídeo tras la publicación del MP4 resultante.
Materiales, instrumento y procedimiento
2.1 · Materiales
El estudio se realizó sobre dos archivos originales generados con herramientas de IA, un JPEG y un MP3, más los archivos derivados obtenidos durante el proceso. La Tabla 1 resume las propiedades de los originales.
| Archivo | Formato | Tamaño | Bloques | Cadenas detectadas | SHA-256 |
|---|---|---|---|---|---|
| imagen_generada.jpg | JPEG | 93.474 B | APP11 · C2PA/JUMBF | c2pa, jumbf, [firma-img], [modelo-img], trainedalgorithmicmedia |
F5F4EDFF…C210BE3B2 |
| Midnight Echo.mp3 | MP3 | 5.380.883 B | ID3v2 (~22.259 B) + portada embebida | c2pa, jumbf, trainedalgorithmicmedia, [firma-audio] |
41994ED8…053E37A54 |
Ambos archivos fueron analizados antes de cualquier transformación. Los hashes SHA-256 se calcularon en el momento del análisis, no a posteriori, y se conservan como referencia de integridad de las entradas.
El JPEG contiene un bloque APP11 con carga C2PA/JUMBF de 21.892 bytes, según la medición registrada en el análisis binario. El MP3 contiene una cabecera ID3v2 de aproximadamente 22.259 bytes con portada embebida (APIC) y frames de datos privados (PRIV).
2.2 · Instrumento
El instrumento principal es Media Clean Lab v2.4, una aplicación de escritorio escrita en Python 3.9+ sobre Tkinter, sin backend ni envío de datos a servidores externos. La aplicación realiza tres operaciones sobre cada archivo: análisis estructural (lectura byte a byte), limpieza binaria (eliminación de bloques sin recodificar) y verificación (re-análisis con el mismo motor y comparación ANTES / DESPUÉS).
Para la construcción del MP4 y la inspección final se utilizó FFmpeg y FFprobe 62.3.100. Los hashes se calcularon con SHA-256 (FIPS PUB 180-4). La observación en plataforma se realizó sobre el panel de administración de la plataforma de vídeo y su página pública.
| Herramienta | Versión | Uso |
|---|---|---|
| Media Clean Lab | 2.4 | Análisis, limpieza y verificación |
| FFmpeg | 62.3.100 | Construcción y remux del MP4 |
| FFprobe | 62.3.100 | Inspección de streams y contenedor |
| SHA-256 | FIPS PUB 180-4 | Huella criptográfica |
| Panel de plataforma | — | Observación de publicación |
2.3 · Procedimiento
El procedimiento se ejecutó en ocho etapas secuenciales.
- Análisis del original. Cada archivo se leyó byte a byte. Se identificaron los bloques de metadata presentes, los tags internos y las cadenas objetivo.
- Cálculo de hash. Se calculó el SHA-256 de cada original antes de cualquier transformación.
- Limpieza binaria. Sobre el JPEG se eliminó estructuralmente el segmento
APP11completo con carga C2PA/JUMBF. Sobre el MP3 se eliminó la cabeceraID3v2(cabecera + frames) y, si hubiera estado presente, el bloqueID3v1. En ningún caso se recodificó imagen ni audio. - Verificación del limpio. Cada archivo resultante se re-analizó con el mismo motor. Para el MP3 se añadió una comprobación de integridad MPEG: se localizaron cabeceras de frame reales y se encadenaron sumando tamaños, comparando versión, layer, sample rate, canales, número de frames y duración calculada.
- Construcción del MP4 de trabajo. Se generó un vídeo H.264 a partir de la imagen limpia y el audio limpio, copiando el audio sin recodificar mediante
-c:a copy. - Remux final. El MP4 de trabajo se remuxeó con
-c copy,-map_metadata -1y-map_chapters -1, sin recodificar streams. - Verificación final. Se ejecutó FFprobe sobre el MP4 final y se realizó una búsqueda binaria de las 7 cadenas objetivo sobre los bytes reales.
- Observación en plataforma. El MP4 final se subió a una plataforma de vídeo como privado. A las 14:28 del 25/09/2026 se realizó la primera comprobación en el panel de administración. Posteriormente se cambió la visibilidad a público.
→
→
→
→
→
ffmpeg -loop 1 -i cover_midnight.jpg \
-i “Midnight Echo_CLEAN.mp3” \
-c:v libx264 -c:a copy \
Midnight_Echo_CLEAN.mp4
# 2) Remux final limpio
ffmpeg -i Midnight_Echo_CLEAN.mp4 \
-map 0 -c copy \
-map_metadata -1 \
-map_chapters -1 \
Midnight_Echo_FINAL.mp4
2.4 · Variables observadas
El estudio mide tres variables principales:
- Variable 1 — Metadata de procedencia presente en los originales. Se registra qué bloques de metadata contienen los archivos originales y qué cadenas objetivo aparecen en ellos.
- Variable 2 — Integridad estructural tras la limpieza. Se comparan, antes y después: versión MPEG, layer, sample rate, bitrate, canales, número de frames válidos y duración.
- Variable 3 — Comportamiento de la plataforma. Se observa si la plataforma de vídeo aplica alguna etiqueta automática de contenido IA al vídeo publicado.
| Cadena | Categoría |
|---|---|
| c2pa | Marcador de estándar |
| jumbf | Contenedor binario |
| [firma-img] | Firma de proveedor (imagen) |
| [modelo-img] | Identificador de modelo (imagen) |
| trainedalgorithmicmedia | Etiqueta semántica |
| [firma-audio] | Firma de proveedor (audio) |
| [firma-video] | Firma de proveedor (vídeo) |
Nota metodológica: las cadenas específicas de proveedor detectadas en los archivos originales han sido sustituidas por marcadores genéricos en este documento para no identificar a terceros. Las mediciones y verificaciones se realizaron sobre las cadenas reales, y su ausencia en el MP4 final se comprobó igualmente sobre los valores originales.
2.5 · Criterios de validación
- Cadenas objetivo. Deben estar presentes en los originales (al menos una) y ausentes en el MP4 final (todas).
- Integridad MPEG. Versión, layer, sample rate y canales idénticos entre original y limpio. Pérdida de frames ≤ 2.
- Remux. Uso obligatorio de
-c copy. Cero recodificaciones de streams. - Metadata estructural. Se acepta
encoder=Lavf62.3.100como metadata normal escrita por el muxer, no como señal de procedencia. - Observación externa. Solo se documenta lo observado directamente. No se hacen inferencias sobre el comportamiento futuro de la plataforma.
2.6 · Limitaciones metodológicas
El estudio presenta cuatro limitaciones que condicionan la interpretación de los resultados. La búsqueda de cadenas opera sobre texto literal en bytes; una señal ofuscada, cifrada o codificada de otra forma no sería detectada. La verificación MPEG detecta frames válidos encadenados a nivel de flujo. El análisis de vídeo depende de FFprobe. Y el estudio es un caso único sin grupo de control. Estas limitaciones se retoman en la sección 5.
Datos medidos
3.1 · Limpieza binaria
La limpieza se realizó sin recodificar el contenido audiovisual en ningún caso. La Tabla 4 resume los archivos resultantes.
| Archivo | Formato | Tamaño | Bloques eliminados | Bytes eliminados | SHA-256 |
|---|---|---|---|---|---|
| cover_midnight.jpg | JPEG | 71.582 B | APP11 · C2PA/JUMBF | 21.892 B | 3C83BE7E…D674D72910 |
| Midnight Echo_CLEAN.mp3 | MP3 | 5.358.624 B | ID3v2 · APIC · PRIV | 22.259 B | F1BD33C8…C531F1EB |
JPEG. Reducción de 93.474 a 71.582 bytes (−21.892 B). El bloque APP11 fue eliminado estructuralmente. La carga de imagen (Image data, 70.560 B) permanece intacta y el archivo sigue siendo un JPEG válido.
MP3. Reducción de 5.380.883 a 5.358.624 bytes (−22.259 B). La cabecera ID3v2 completa fue eliminada. El flujo MPEG de audio permanece sin tocar.
3.2 · Integridad estructural del audio
La comparación de la estructura MPEG antes y después de la limpieza se recoge en la Tabla 5.
| Parámetro | Antes | Después | Resultado |
|---|---|---|---|
| Formato detectado | MP3 | MP3 | ✓ idéntico |
| Versión MPEG | MPEG1 | MPEG1 | ✓ idéntico |
| Layer | III | III | ✓ idéntico |
| Frames válidos | 8.820 | 8.820 | ✓ idéntico |
| Sample rate | 48.000 Hz | 48.000 Hz | ✓ idéntico |
| Bitrate | 192 kbps | 192 kbps | ✓ idéntico |
| Canales | 2 (estéreo) | 2 (estéreo) | ✓ idéntico |
| Duración | 229,97 s | 229,97 s | ✓ idéntico |
No se perdió ningún frame, no cambió la versión, no cambió el layer, no cambió el sample rate ni el número de canales. La estructura MPEG se conserva idéntica. El veredicto emitido por el instrumento para el audio limpio es LIMPIO Y VÁLIDO, el veredicto más estricto, que solo se aplica cuando desaparecen los identificadores objetivo y la estructura MPEG sigue siendo reproducible.
3.3 · Construcción del MP4
La construcción del contenedor final se realizó en dos pasadas. El MP4 de trabajo se generó directamente con FFmpeg a partir de la imagen limpia y el audio limpio, con vídeo H.264 a 1024×1024 y 25 fps, audio MP3 copiado sin recodificación, y un tamaño final de 8.786.910 B. El MP4 final se obtuvo mediante remux con -c copy, -map_metadata -1 y -map_chapters -1, sin recodificación de streams. El contenedor conserva encoder=Lavf62.3.100, que es metadata normal escrita por FFmpeg/libavformat durante el muxing y no constituye un identificador de ningún proveedor de IA.
Ninguno de los dos MP4 tiene SHA-256 registrado. La ausencia no significa que no sean calculables: significa que ese valor no fue incorporado a la trazabilidad documental de esta validación. El informe establece explícitamente que no deben introducirse hashes a posteriori presentándolos como si hubieran formado parte del registro original del proceso.
3.4 · Verificación final del MP4
Se ejecutó FFprobe sobre el MP4 final y se realizó una búsqueda binaria de las 7 cadenas objetivo sobre los bytes reales del archivo. La Tabla 6 resume los resultados.
| Cadena | Resultado |
|---|---|
| c2pa | ✗ no encontrada |
| jumbf | ✗ no encontrada |
| [firma-img] | ✗ no encontrada |
| [modelo-img] | ✗ no encontrada |
| trainedalgorithmicmedia | ✗ no encontrada |
| [firma-audio] | ✗ no encontrada |
| [firma-video] | ✗ no encontrada |
Resultado global: 0 coincidencias en los bytes examinados.
La comprobación es sobre cadenas literales presentes o ausentes en los bytes del MP4 final, no sobre el origen del contenido. La ausencia de esas cadenas no debe interpretarse como que el contenido haya dejado de ser generado por IA: el contenido es el mismo que el del original; lo único que ha cambiado es la metadata.
3.5 · Observación en plataforma
El MP4 final se subió a una plataforma de vídeo el 25/09/2026. El procedimiento seguido y los estados observados se recogen en la Tabla 7.
| Momento | Acción | Estado observado |
|---|---|---|
| 25/09/2026 | Subida inicial como privado | — |
| 25/09/2026 · 14:28 | Primera comprobación en el panel de administración | Sección de declaración de IA sin selección automática |
| Posterior | Cambio de visibilidad a público | — |
| Posterior | Adición de comentario fijado | — |
| Posterior | Adición de descripción | — |
| Posterior | Comprobación de página pública | Sin etiqueta automática de contenido IA |
El estado documentado al cierre del estudio es: publicación realizada · comportamiento de la plataforma en observación.
No se observó ninguna etiqueta automática de contenido IA en la página pública en el momento de la comprobación. No se afirma que la plataforma haya certificado el archivo como no generado por IA. La ausencia de la etiqueta en esta comprobación no permite determinar el comportamiento futuro de la plataforma ni constituye garantía sobre clasificaciones posteriores.
3.6 · Trazabilidad de hashes
| Archivo | SHA-256 registrado |
|---|---|
| imagen_generada.jpg (original) | ✓ |
| Midnight Echo.mp3 (original) | ✓ |
| cover_midnight.jpg (limpio) | ✓ |
| Midnight Echo_CLEAN.mp3 (limpio) | ✓ |
| Midnight_Echo_CLEAN.mp4 (trabajo) | ✗ NO REGISTRADO |
| Midnight_Echo_FINAL.mp4 (final) | ✗ NO REGISTRADO |
3.7 · Resumen de resultados
Los datos obtenidos se pueden resumir en cuatro puntos:
- Los archivos originales contenían firmas de IA identificables: bloque
APP11/C2PA/JUMBF de 21.892 B en el JPEG; cabeceraID3v2de 22.259 B en el MP3. - La limpieza fue binaria y no alteró el contenido. La integridad MPEG del audio se conserva idéntica.
- El MP4 final no contiene las 7 cadenas objetivo: 0 coincidencias en la búsqueda binaria.
- No se observó la etiqueta automática de contenido IA en la página pública. La observación se realizó en las condiciones documentadas.
Qué significan los datos
4.1 · La separación entre contenedor y contenido
El resultado central de este estudio no es que la limpieza funcione. Es que la limpieza funcione sin tocar el contenido. Esa es la observación que articula todo lo demás.
Un archivo digital es, en la práctica, dos cosas superpuestas: un flujo de datos audiovisuales y un envoltorio de información sobre ese flujo. El primero es lo que se ve y se oye. El segundo es lo que dice quién, cuándo y con qué se produjo. C2PA vive enteramente en el segundo. El bloque APP11 de un JPEG, la cabecera ID3v2 de un MP3, los manifiestos JUMBF firmados criptográficamente: todo eso es información sobre el archivo, no el archivo.
La consecuencia es directa: si la procedencia vive en el envoltorio, eliminar el envoltorio elimina la procedencia. Y eliminar el envoltorio no altera el contenido. Los datos de este estudio lo confirman: el JPEG perdió 21.892 bytes y su carga de imagen permanece intacta; el MP3 perdió 22.259 bytes y sus 8.820 frames MPEG siguen exactamente igual, con el mismo sample rate, el mismo bitrate y la misma duración.
Esto no es un fallo de C2PA. Es una propiedad de su diseño. El estándar fue concebido para que un actor cooperativo pueda declarar el origen de su contenido y que otro actor cooperativo pueda verificarlo. No fue concebido para resistir a un actor que quiera eliminar esa declaración. C2PA es un mecanismo de confianza, no un mecanismo de detección.
4.2 · La fragilidad como propiedad, no como defecto
Una lectura ingenua de los resultados podría concluir que C2PA «no sirve». Esa conclusión es incorrecta. C2PA sirve para lo que fue diseñado: permitir que quien produce contenido declare su origen y que quien lo consume pueda verificarlo. Un manifiesto firmado criptográficamente acredita que el contenido proviene de quien dice provenir, y que no ha sido modificado desde que se firmó.
Lo que C2PA no puede hacer, y nunca pretendió hacer, es obligar a que la declaración permanezca. Cualquier estándar que deposite información en un contenedor eliminable tiene esta propiedad: la información es tan robusta como el contenedor que la aloja. Y los contenedores de formatos estándar (JPEG, MP3, MP4) están diseñados para ser manipulables, no para ser inmutables.
Esto tiene una consecuencia para el debate regulatorio que conviene explicitar: la obligación de marcar contenido sintético «de forma legible por máquina», tal como aparece en el artículo 50 del AI Act, es una obligación sobre el productor, no sobre el archivo. El productor debe insertar la marca. El estándar no garantiza que esa marca sobreviva a cualquier transformación posterior, porque no puede hacerlo sin cambiar radicalmente el modelo de formato de archivo.
4.3 · La tensión regulatoria
El AI Act sitúa la marca legible por máquina como mecanismo de transparencia. La premisa implícita es que esa marca permitirá a los sistemas downstream identificar contenido sintético y actuar en consecuencia: etiquetarlo en una plataforma, filtrarlo en un buscador, o simplemente informar al usuario.
Los resultados de este estudio acotan el alcance de esa premisa. Si un archivo generado por IA puede ser limpiado de su metadata sin alterar su contenido, entonces la marca legible por máquina es condición necesaria pero no suficiente para la transparencia. Es necesaria porque sin ella ningún sistema puede saber que el contenido es sintético. No es suficiente porque su presencia depende de que nadie la elimine, y su eliminación es trivial.
Esto no invalida la obligación del artículo 50. La hace dependiente de un supuesto que no siempre se cumple: que el productor quiera declarar. Para el productor cooperativo, la obligación funciona. Para el productor que prefiere no declarar, la obligación no tiene mecanismo de enforcement técnico. La única vía de enforcement es legal: sancionar al productor que no marca. Pero sancionar requiere detectar, y detectar requiere que la marca esté presente.
4.4 · Qué se puede y qué no se puede inferir de la observación en la plataforma
El resultado observado es que la página pública del vídeo no mostraba la etiqueta automática de contenido IA en el momento de la comprobación. Eso es un hecho. Lo que no se puede inferir de ese hecho es por qué.
Hay al menos tres explicaciones compatibles con la observación:
- Primera. La plataforma detecta el contenido sintético a través de la metadata C2PA, y al no encontrarla, no aplica la etiqueta. Esta es la explicación que el diseño del estudio sugiere, pero no la demuestra.
- Segunda. La plataforma no detecta contenido sintético a través de C2PA en absoluto, y aplica la etiqueta solo cuando el usuario la declara manualmente. En ese caso, la ausencia de etiqueta no tendría nada que ver con la limpieza de metadata.
- Tercera. La plataforma aplica la etiqueta en función de otros criterios (tipo de contenido, duración, cuenta, región, umbrales internos) que no han sido observados en este estudio.
El diseño del estudio no permite distinguir entre estas tres explicaciones porque no incluye un grupo de control. Es la limitación más importante del trabajo y se retoma en la sección 5.
4.5 · La frontera entre metadata y contenido
Hay una distinción que el estudio hace explícita y que conviene subrayar: el origen del contenido no cambia cuando cambia su metadata. El vídeo publicado sigue siendo el mismo vídeo generado por IA. Lo único que ha cambiado es que ya no lleva la etiqueta que lo declaraba.
Decir «el archivo está limpio» no significa «el contenido no es de IA». Significa «el archivo no contiene las señales de procedencia que contenía antes». La distinción no es semántica: es la diferencia entre describir un estado técnico y emitir un juicio sobre el origen.
4.6 · Implicaciones para el ecosistema de procedencia
Si la metadata es eliminable trivialmente, ¿qué alternativas existen para preservar la trazabilidad? Hay tres líneas de trabajo activas, ninguna exenta de problemas.
- Watermarking invisible. Insertar una señal en el propio contenido que sobreviva a transformaciones. Es la aproximación más robusta en teoría, pero implica modificar el contenido y los watermarkings existentes son vulnerables a ataques específicos.
- Detección por análisis de artefactos. Inferir el origen a partir de características estadísticas del contenido. No requiere modificar el contenido, pero es probabilística y su fiabilidad decae a medida que los generadores mejoran.
- Registro externo. Asociar el contenido a un registro externo firmado mediante un hash. Preserva la trazabilidad si el hash está registrado y si alguien lo consulta, pero no impide que el contenido se publique sin pasar por el registro.
Ninguna de las tres resuelve el problema por sí sola. La conclusión razonable es que la trazabilidad robusta requerirá una combinación de mecanismos. El estándar C2PA, en este contexto, es una pieza útil pero no una solución completa: funciona para actores cooperativos, no para actores adversariales.
Fronteras del estudio
5.1 · Limitaciones
Las limitaciones que se enumeran a continuación no son defectos del trabajo, sino fronteras explícitas de lo que sus datos permiten afirmar.
- Ausencia de grupo de control. Es la limitación más importante. No se comparó el comportamiento de la plataforma ante el mismo contenido con la metadata intacta. Sin ese segundo caso, la relación entre limpieza y ausencia de etiqueta no puede establecerse causalmente.
- Una sola plataforma. La plataforma utilizada es un caso. Otras plataformas tienen sus propios sistemas de etiquetado y sus propios criterios. Los resultados observados no se extrapolan a ninguna otra.
- Un solo formato de publicación. Se publicó un MP4. Otros formatos tienen comportamientos distintos en plataformas distintas.
- Una sola cuenta y una sola región. La cuenta y su región geográfica pueden influir en cómo la plataforma clasifica el contenido.
- Una sola fecha. Los sistemas de detección cambian con el tiempo. Lo que no se observó el 25/09/2026 puede observarse semanas o meses después.
- Una sola versión de C2PA. No se ha verificado la versión específica del manifiesto C2PA que portaban los archivos originales.
- Búsqueda de cadenas literales. Una señal ofuscada, cifrada o codificada de otra forma no sería detectada por este método.
- Análisis de vídeo delegado. La inspección del MP4 depende de FFprobe. Los metadatos que FFprobe no expone no forman parte de las mediciones.
- Hashes no registrados. Los dos archivos MP4 del proceso no tienen SHA-256 registrado. No se han calculado a posteriori porque hacerlo rompería la trazabilidad del registro original.
- Cadenas de proveedor anonimizadas. Las cadenas específicas de proveedor detectadas en los archivos originales se han sustituido por marcadores genéricos en este documento. Las mediciones se realizaron sobre los valores reales.
5.2 · Trabajo futuro
Las limitaciones anteriores sugieren líneas concretas de trabajo posterior.
- Grupo de control. Replicar el experimento con dos subidas idénticas: una con metadata intacta y otra con metadata eliminada, a la misma cuenta, en la misma fecha. La comparación permitiría aislar el efecto de la limpieza sobre la clasificación.
- Ampliación a múltiples plataformas. El mismo procedimiento aplicado a otras plataformas de vídeo, redes sociales y servicios de distribución permitiría comparar criterios de etiquetado.
- Ampliación a múltiples formatos. Publicar el mismo contenido como imagen suelta, audio suelto, vídeo corto y vídeo largo.
- Observación longitudinal. Repetir la comprobación a intervalos regulares (24 h, 72 h, 7 días, 30 días) para documentar si la plataforma reclasifica el contenido con el tiempo.
- Determinación de la versión C2PA. Analizar los archivos originales con herramientas específicas de C2PA para determinar la versión exacta del manifiesto.
- Análisis de otras señales de procedencia. Ampliar la búsqueda a marcas de agua invisibles, esteganografía y otras señales no textuales.
- Registro sistemático de hashes. Incorporar el cálculo de SHA-256 de todos los archivos intermedios y finales al procedimiento estándar.
5.3 · Sobre la naturaleza de este estudio
Un estudio de caso único no produce resultados generalizables. Produce un registro verificable de un estado observado en condiciones controladas. Su valor no reside en la extrapolación, sino en la trazabilidad: cada afirmación está respaldada por una medición concreta, cada archivo tiene un hash o una declaración explícita de no registro, y cada observación se limita a lo efectivamente comprobado.
Eso es lo que hace que este trabajo sea citable y reproducible, y también lo que lo hace modesto en sus conclusiones. No dice «las plataformas no detectan contenido IA sin metadata». Dice: «en el caso observado, en las condiciones documentadas, en la fecha indicada, no se observó la etiqueta».
Lo que queda cuando la prueba desaparece
Este trabajo partió de una pregunta simple: ¿qué queda del origen de un archivo cuando le quitas su metadata? La respuesta que arrojan los datos es también simple, y por eso mismo incómoda: queda todo, menos la prueba.
El contenido audiovisual permanece idéntico. Los 8.820 frames MPEG del audio, el mismo sample rate, el mismo bitrate, la misma duración. La carga de imagen del JPEG, intacta. Lo único que desaparece son los 21.892 bytes del bloque APP11 y los 22.259 bytes de la cabecera ID3v2, más las cadenas que viajaban dentro de ellos. El archivo limpio es, byte a byte, el mismo contenido con un envoltorio distinto.
Eso significa que C2PA hace exactamente lo que fue diseñado para hacer: permitir que quien produce contenido declare su origen y que quien lo consume pueda verificarlo. Y significa también que C2PA no hace lo que a veces se le atribuye: no impide que esa declaración desaparezca. El estándar es un mecanismo de confianza entre actores cooperativos, no un sistema de detección resistente a la manipulación.
La consecuencia para el debate regulatorio es directa. La obligación del artículo 50 del AI Act de marcar el contenido sintético de forma legible por máquina es una obligación sobre el productor, no una propiedad del archivo. Funciona para quien quiere cumplirla. No funciona como mecanismo de enforcement técnico frente a quien prefiere no cumplirla, porque eliminar la marca es trivial y no deja rastro en el contenido.
Los resultados de este estudio no permiten afirmar que las plataformas no detecten contenido IA sin metadata. Permiten afirmar que, en el caso observado, en las condiciones documentadas y en la fecha indicada, no se observó la etiqueta. La distancia entre ambas afirmaciones es la distancia entre un dato y una opinión, y este trabajo se queda deliberadamente del lado del dato.
La pregunta que deja abierta no es si la limpieza funciona. Eso está demostrado. La pregunta es qué tipo de trazabilidad se puede construir cuando la prueba de procedencia vive en un envoltorio que cualquiera puede cambiar sin tocar lo que envuelve. Ninguna de las alternativas actuales —watermarking invisible, detección por artefactos, registro externo— resuelve el problema por sí sola. La conclusión razonable es que la trazabilidad robusta requerirá una combinación de mecanismos, y que ningún mecanismo único va a ser suficiente. El estándar C2PA, en ese contexto, es una pieza útil. No es la solución completa.
Recorrido interactivo del pipeline
El material que sigue es un complemento visual al artículo. No añade información nueva ni sustituye a ninguna de las secciones anteriores. Su función es ofrecer una representación secuencial de las seis etapas del proceso, útil para quien quiera una visión de conjunto antes de volver al texto o para quien prefiera recorrer el pipeline de forma visual antes de profundizar en los detalles técnicos.
Recorrido interactivo
6 pasos · ~ 14 segundos
2 · ANALYZE
3 · CLEAN
4 · VERIFY
5 · BUILD
6 · PUBLISH
Las cifras, offsets y nombres de archivo que aparecen en el recorrido son los documentados en las secciones 2 y 3 de este artículo. El recorrido no introduce mediciones nuevas.
Visitas: 9
Automation & Data Specialist | Web Development | Data Processing & Integration