
Partitioning y Partition Pruning en MySQL: cómo optimizar tablas grandes
Cuando una base de datos empieza a crecer de verdad, llega un momento en el que las consultas que antes respondían prácticamente al instante comienzan a necesitar cada vez más tiempo.
Y aquí es donde empiezan a aparecer conceptos como índices, optimización de consultas, particionamiento y, en determinados escenarios, partition pruning.
En este artículo vamos a centrarnos en estos dos últimos conceptos: Partitioning y Partition Pruning en MySQL.
La idea es entender qué son, cómo funcionan, cuándo pueden ayudarnos y, algo todavía más importante, cuándo no debemos utilizarlos.
Particionar una tabla no hace que mágicamente todas nuestras consultas sean más rápidas. El beneficio aparece cuando el diseño del particionado encaja con el patrón real de acceso a los datos.
¿Qué es el partitioning en MySQL?
El partitioning o particionamiento consiste en dividir físicamente los datos de una tabla en diferentes particiones, manteniendo para nuestra aplicación la apariencia de una única tabla lógica.
Por ejemplo, imaginemos una tabla llamada:
logs
que lleva varios años almacenando millones de registros.
Podríamos organizar los datos utilizando la fecha de creación:
- p2023 → registros de 2023
- p2024 → registros de 2024
- p2025 → registros de 2025
- p2026 → registros de 2026
Para nuestra aplicación seguimos trabajando con:
SELECT * FROM logs;
Pero internamente MySQL mantiene los datos distribuidos entre las diferentes particiones.
MySQL 8.4 soporta particionamiento definido por el usuario con InnoDB y NDB. En una instalación habitual con InnoDB, será este el escenario que normalmente nos encontraremos. :contentReference[oaicite:1]{index=1}
¿Por qué querríamos particionar una tabla?
Uno de los escenarios más habituales es trabajar con tablas que crecen continuamente.
Por ejemplo:
logs
eventos
auditoria
transacciones
historico_pedidos
mediciones
estadisticas
Imaginemos una tabla de logs con 500 millones de registros.
Si nuestra aplicación realiza constantemente consultas relacionadas con un periodo concreto:
SELECT *
FROM logs
WHERE created_at >= '2026-01-01'
AND created_at < '2026-02-01';
Puede tener sentido organizar los datos de forma que MySQL pueda identificar rápidamente qué particiones pueden contener esos registros.
Y aquí aparece nuestro segundo protagonista.
¿Qué es el Partition Pruning?
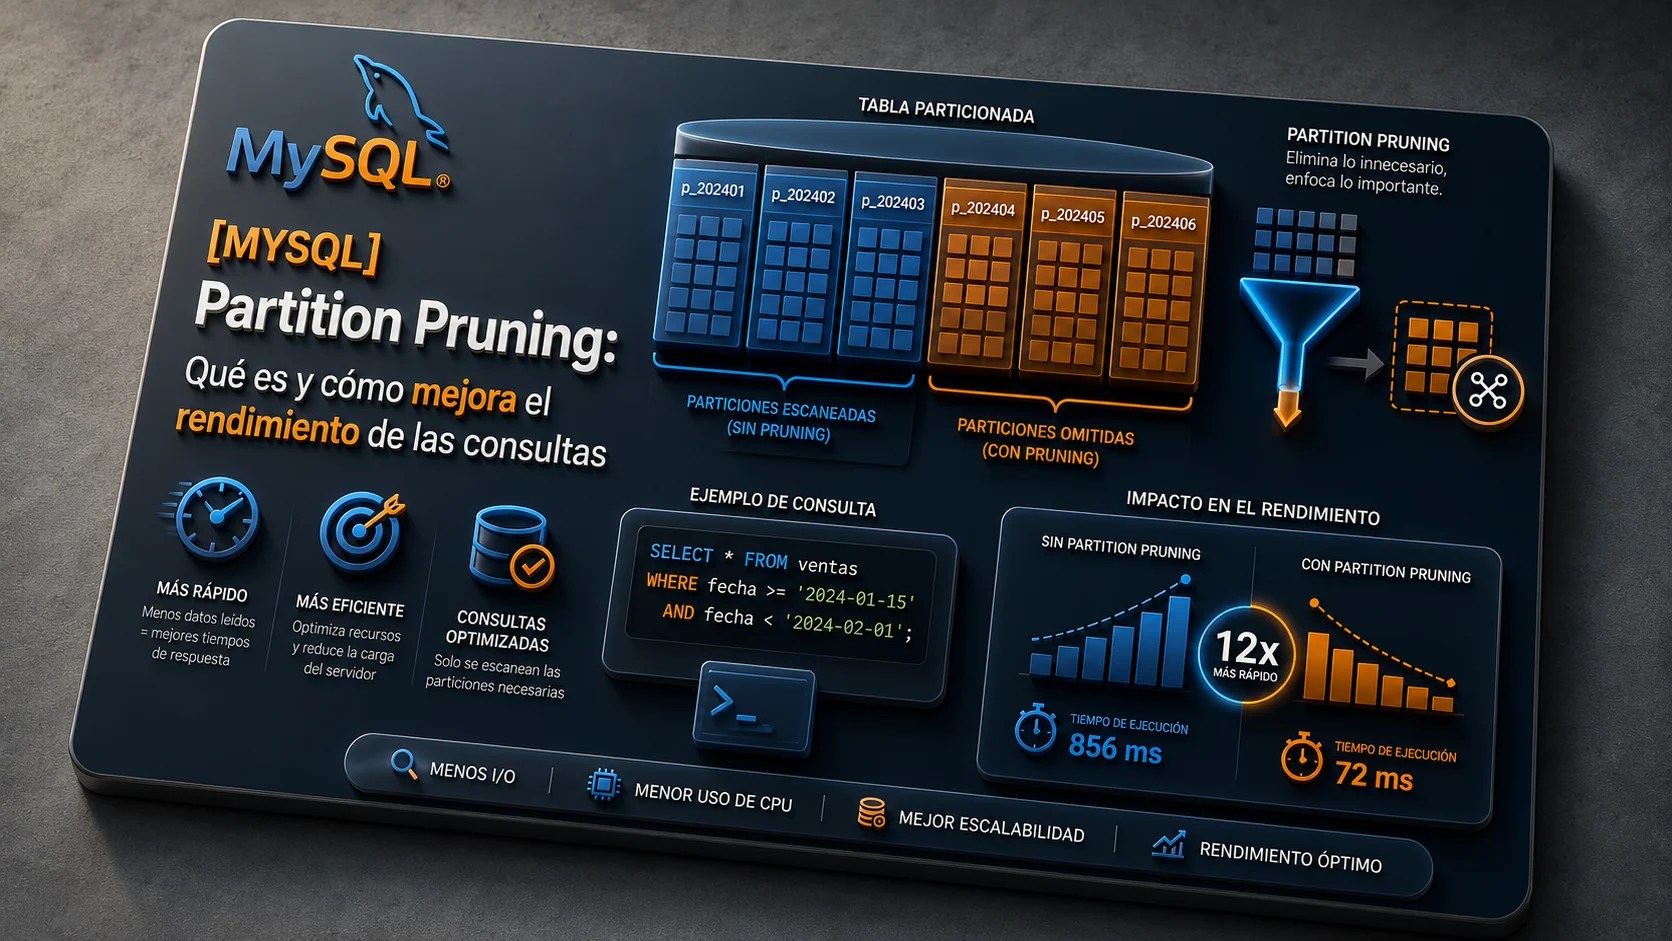
Partition Pruning, o poda de particiones, es una optimización que realiza MySQL para evitar consultar particiones que no pueden contener filas que satisfagan nuestra consulta.
La idea es muy sencilla:
Si MySQL sabe que una partición no puede contener ningún registro que cumpla nuestro
WHERE, no necesita leerla.
Por ejemplo, si tenemos:
p2023
p2024
p2025
p2026
y ejecutamos una consulta que solamente puede devolver datos de 2026, MySQL puede descartar las particiones anteriores.
Conceptualmente:
p2023 → ignorada
p2024 → ignorada
p2025 → ignorada
p2026 → consultada
Eso es partition pruning.
La documentación de MySQL describe precisamente esta optimización como evitar el escaneo de particiones en las que no puede existir ningún valor coincidente. :contentReference[oaicite:2]{index=2}
Un ejemplo práctico
Vamos a construir una tabla sencilla para entenderlo.
CREATE TABLE logs (
    id BIGINT NOT NULL,
    created_at DATETIME NOT NULL,
    mensaje VARCHAR(255),
    PRIMARY KEY (id, created_at)
)
PARTITION BY RANGE (YEAR(created_at)) (
    PARTITION p2023 VALUES LESS THAN (2024),
    PARTITION p2024 VALUES LESS THAN (2025),
    PARTITION p2025 VALUES LESS THAN (2026),
    PARTITION p2026 VALUES LESS THAN (2027),
    PARTITION pfuture VALUES LESS THAN MAXVALUE
);
Hemos creado diferentes particiones en función del año de created_at.
Ahora imaginemos una consulta como esta:
SELECT *
FROM logs
WHERE created_at >= '2026-01-01'
AND created_at < '2027-01-01';
El optimizador puede determinar que los registros que nos interesan pertenecen a la partición correspondiente a 2026.
Por tanto, conceptualmente, la búsqueda queda reducida a:
p2023   → NO
p2024   → NO
p2025   → NO
p2026   → SÍ
pfuture → NO
En lugar de trabajar sobre todas las particiones, solamente necesita considerar la relevante.
¿Cómo podemos comprobar si MySQL está haciendo pruning?
No debemos quedarnos simplemente con la teoría.
Una de las mejores herramientas que tenemos para comprobar cómo está ejecutando MySQL nuestra consulta es:
EXPLAIN
Por ejemplo:
EXPLAIN
SELECT *
FROM logs
WHERE created_at >= '2026-01-01'
AND created_at < '2027-01-01';
En una tabla particionada, podemos fijarnos especialmente en la información relacionada con las particiones que serán utilizadas.
También podemos utilizar:
EXPLAIN ANALYZE
SELECT *
FROM logs
WHERE created_at >= '2026-01-01'
AND created_at < '2027-01-01';
Esto es especialmente interesante porque nos permite comparar el plan estimado con la ejecución real.
No optimicemos a ciegas. Primero medimos, después modificamos y finalmente volvemos a medir.
¿Cuándo puede funcionar el partition pruning?
El pruning puede utilizarse cuando el optimizador puede determinar qué particiones pueden contener los valores buscados.
Uno de los casos más sencillos es una igualdad:
WHERE region_code = 100
También puede funcionar con rangos:
WHERE region_code >= 100
AND region_code < 150
Y determinadas consultas que utilizan BETWEEN también pueden beneficiarse:
WHERE region_code BETWEEN 100 AND 150
MySQL documenta pruning para condiciones que pueden reducirse a valores o rangos que permitan determinar las particiones relevantes. :contentReference[oaicite:3]{index=3}
Un detalle importante: no basta con tener un WHERE
Aquí tenemos uno de los errores más habituales.
Que nuestra consulta tenga un WHERE no significa automáticamente que MySQL vaya a realizar partition pruning.
Imaginemos que nuestra tabla está particionada por:
created_at
pero hacemos esta consulta:
SELECT *
FROM logs
WHERE cliente_id = 10;
MySQL sabe qué cliente queremos, pero eso no le indica en qué partición se encuentran sus registros.
Si el particionado se ha realizado utilizando created_at, el filtro sobre cliente_id no proporciona información suficiente para descartar particiones.
Por tanto, podría necesitar consultar múltiples particiones.
El enemigo: aplicar funciones innecesarias a la columna
Otro punto importante es cómo escribimos nuestras consultas.
Supongamos que tenemos:
created_at DATETIME
Una consulta como esta puede dificultar que el optimizador determine directamente el rango de particiones:
WHERE YEAR(created_at) = 2026
En muchos escenarios será preferible expresar directamente el rango temporal:
WHERE created_at >= '2026-01-01'
AND created_at < '2027-01-01'
De esta manera estamos proporcionando al optimizador un rango directamente relacionado con la columna.
Además, esta forma de escribir la consulta suele ser más clara y evita depender de transformaciones sobre la columna.
Partitioning no sustituye a los índices
Esto merece estar escrito en letras grandes.
PARTITIONING ≠ INDEX
Una tabla particionada sigue necesitando un diseño adecuado de índices.
El partitioning divide los datos en particiones, mientras que los índices permiten localizar registros eficientemente dentro de los datos que corresponda consultar.
Son mecanismos diferentes y pueden complementarse.
Por ejemplo, podemos tener una tabla particionada por fecha y, además, índices adecuados para las consultas que realizamos dentro de cada partición.
Tipos de particionamiento en MySQL
MySQL dispone de diferentes estrategias de particionamiento.
RANGE
Divide los datos según rangos.
Es especialmente interesante cuando trabajamos con fechas o valores ordenables.
PARTITION BY RANGE (YEAR(created_at))
Podemos tener:
p2024
p2025
p2026
pfuture
RANGE COLUMNS
Permite realizar particionamiento por rangos utilizando columnas directamente.
Por ejemplo:
PARTITION BY RANGE COLUMNS (created_at)
Puede ser una alternativa muy interesante cuando trabajamos directamente con fechas.
LIST
Permite distribuir los registros según determinados valores.
Por ejemplo, podría utilizarse para separar regiones o categorías concretas.
PARTITION BY LIST (region_id)
MySQL también dispone de LIST COLUMNS para determinados tipos de columnas. :contentReference[oaicite:4]{index=4}
HASH
Distribuye los registros mediante una función hash.
PARTITION BY HASH(cliente_id)
PARTITIONS 8
Puede ser útil para distribuir los datos de forma relativamente uniforme entre varias particiones.
KEY
Es similar a HASH, pero es MySQL quien proporciona la función hash utilizada.
PARTITION BY KEY()
PARTITIONS 8
En determinadas situaciones puede utilizar la clave primaria como base del particionamiento. :contentReference[oaicite:5]{index=5}
Una restricción MUY importante: PRIMARY KEY y UNIQUE
Aquí tenemos algo que suele sorprender cuando empezamos a trabajar con particiones.
En MySQL, las columnas utilizadas en la expresión de particionamiento deben formar parte de todas las claves únicas de la tabla.
Esto incluye la PRIMARY KEY.
Por ejemplo, esta tabla:
CREATE TABLE usuarios (
    id INT NOT NULL AUTO_INCREMENT,
    created_at DATETIME NOT NULL,
    email VARCHAR(255) NOT NULL,
    PRIMARY KEY (id),
    UNIQUE KEY uk_email (email)
);
no se puede convertir alegremente en una tabla particionada por created_at manteniendo esas claves tal cual.
La razón es que created_at tendría que formar parte de todas las claves únicas relevantes.
La documentación oficial de MySQL establece esta restricción explícitamente. :contentReference[oaicite:6]{index=6}
Por eso, antes de particionar una tabla existente, debemos revisar cuidadosamente:
- PRIMARY KEY.
- UNIQUE KEY.
- Índices existentes.
- Consultas habituales.
- Claves foráneas y relaciones.
- Volumen real de datos.
Este es uno de los motivos por los que particionar una tabla existente no debe hacerse a la ligera.
¿Podemos particionar una tabla que ya existe?
Sí, podemos utilizar ALTER TABLE para modificar la estrategia de particionamiento, siempre respetando las restricciones que afectan a las tablas particionadas.
Por ejemplo, conceptualmente:
ALTER TABLE logs
PARTITION BY RANGE (YEAR(created_at)) (
    PARTITION p2024 VALUES LESS THAN (2025),
    PARTITION p2025 VALUES LESS THAN (2026),
    PARTITION p2026 VALUES LESS THAN (2027),
    PARTITION pfuture VALUES LESS THAN MAXVALUE
);
Pero cuidado.
Una operación de este tipo puede implicar trabajo considerable sobre una tabla grande. Además, las restricciones de las claves siguen siendo aplicables. :contentReference[oaicite:7]{index=7}
Antes de hacerlo en producción, deberíamos probar el procedimiento sobre una copia o entorno de staging.
Partition pruning y DELETE
El pruning no está limitado a las consultas SELECT.
También puede intervenir en operaciones como:
DELETE
Por ejemplo:
DELETE FROM logs
WHERE created_at >= '2023-01-01'
AND created_at < '2024-01-01';
Si la tabla está particionada por fecha y el optimizador puede determinar las particiones afectadas, puede evitar consultar las que no corresponden.
MySQL documenta el uso de partition pruning en operaciones SELECT, DELETE y UPDATE, entre otras. :contentReference[oaicite:8]{index=8}
Una ventaja especialmente interesante: gestionar históricos
El particionamiento por fecha puede resultar muy interesante en sistemas donde los datos tienen una vida temporal muy clara.
Imaginemos:
logs_2023
logs_2024
logs_2025
logs_2026
Con una tabla particionada, podemos mantener conceptualmente una única tabla:
logs
y administrar sus particiones individualmente.
Esto puede ser especialmente útil en sistemas de:
- Logs.
- Auditoría.
- Eventos.
- Métricas.
- Históricos.
- Telemetría.
- Transacciones.
Además, el particionamiento puede facilitar determinadas tareas de mantenimiento, como trabajar con periodos concretos de datos, aunque siempre debemos evaluar el diseño y las necesidades concretas del sistema.
¿Particionar siempre mejora el rendimiento?
No.
Y esta probablemente sea la conclusión más importante de todo el artículo.
Particionar una tabla porque tiene muchos registros no garantiza que nuestras consultas vayan a ser más rápidas.
De hecho, un mal diseño puede complicar la gestión de la tabla y no aportar ninguna ventaja real.
Antes de plantearnos partitioning deberíamos preguntarnos:
- ¿Qué consultas realizamos habitualmente?
- ¿Filtramos frecuentemente por la columna que queremos utilizar para particionar?
- ¿Tenemos realmente un volumen de datos que justifique el particionado?
- ¿Nuestros índices están correctamente diseñados?
- ¿Hemos medido el rendimiento actual?
- ¿El coste de mantenimiento compensa el beneficio?
Un error muy común: particionar por una columna que nadie utiliza
Imaginemos que tenemos una tabla con 500 millones de registros.
Decidimos particionarla por:
cliente_id
Pero el 90% de nuestras consultas realmente utilizan:
created_at
En ese caso, nuestro precioso particionamiento puede no aportar el beneficio que esperábamos.
El diseño debe partir de los patrones reales de acceso a los datos, no simplemente del tamaño de la tabla.
Partitioning frente a una tabla normal con buenos índices
Antes de particionar, debemos comparar el comportamiento de una tabla normal correctamente indexada.
Por ejemplo:
CREATE INDEX idx_logs_created_at
ON logs(created_at);
Y después medir:
EXPLAIN ANALYZE
SELECT *
FROM logs
WHERE created_at >= '2026-01-01'
AND created_at < '2026-02-01';
Si el índice ya proporciona un rendimiento excelente, introducir particionamiento puede no aportar una mejora suficiente como para justificar la complejidad adicional.
¿Cómo saber si realmente merece la pena?
Tenemos una regla bastante sencilla:
- Medir la consulta actual.
- Analizar el plan de ejecución.
- Revisar los índices.
- Analizar el volumen y distribución de los datos.
- Diseñar una estrategia de particionamiento.
- Probarla con datos representativos.
- Comparar resultados.
Herramientas como:
EXPLAIN
EXPLAIN ANALYZE
son nuestros mejores aliados.
Partition pruning explicado de forma sencilla
Si tuviéramos que quedarnos con una única idea, sería esta:
TABLA
│
├── p2023
├── p2024
├── p2025
└── p2026
Consulta:
WHERE created_at >= '2026-01-01'
AND created_at < '2027-01-01'
MySQL puede determinar:
p2023  → descartar
p2024  → descartar
p2025  → descartar
p2026  → consultar
Eso es partition pruning.
Menos particiones candidatas significa potencialmente menos trabajo para el motor.
Partitioning no es magia
Es importante no caer en la típica frase:
"Tengo una tabla enorme, la particiono y automáticamente todo irá más rápido".
No funciona así.
El particionamiento es una herramienta de diseño de almacenamiento y acceso a los datos. Su eficacia depende de cómo estén distribuidos los datos y, sobre todo, de cómo se consulten.
Un buen índice puede ser mucho más importante que introducir particiones.
Y una consulta bien diseñada puede ser mucho más importante que cualquiera de las dos cosas.
Partitioning vs. Partition Pruning
| Concepto | Qué hace |
|---|---|
| Partitioning | Divide una tabla en diferentes particiones. |
| Partition Pruning | Permite a MySQL ignorar las particiones que no pueden contener resultados. |
| Index | Ayuda a localizar registros eficientemente dentro de los datos consultados. |
Casos donde puede tener mucho sentido
El particionamiento puede ser especialmente interesante cuando tenemos:
- Tablas realmente grandes.
- Datos que crecen de manera continua.
- Un criterio de separación natural, como una fecha.
- Consultas que filtran habitualmente por ese criterio.
- Necesidad de gestionar históricos.
- Procesos periódicos de mantenimiento o archivado.
Un sistema de logs es un ejemplo bastante intuitivo:
2023 ──────────────┐
2024 ──────────────┤
2025 ──────────────┤── logs
2026 ──────────────┘
Si nuestra aplicación consulta constantemente "los logs de este mes", el modelo encaja mucho mejor que si nuestras consultas fueran completamente aleatorias.
Errores que debemos evitar
- Particionar simplemente porque la tabla es grande.
- Ignorar los índices existentes.
- Particionar por una columna que apenas aparece en nuestras consultas.
- Suponer que cualquier
WHEREactivará pruning. - No comprobar el plan de ejecución.
- Ignorar las restricciones de PRIMARY KEY y UNIQUE.
- Crear demasiadas particiones sin una razón clara.
- Modificar una tabla de producción sin probar antes el cambio.
Conclusión
El partitioning es una herramienta muy potente para determinados escenarios de bases de datos grandes, especialmente cuando existe una forma natural de dividir los datos, como ocurre con fechas, rangos o determinadas categorías.
Pero el verdadero protagonista de este artículo es el partition pruning.
Cuando MySQL puede determinar que determinadas particiones no pueden contener los registros que buscamos, puede descartarlas antes de realizar el trabajo necesario para obtener los resultados.
La clave está en diseñar correctamente las particiones y escribir consultas que permitan al optimizador identificar qué partes de la tabla son relevantes. :contentReference[oaicite:9]{index=9}
Y sobre todo:
No particiones porque puedas. Particiona porque tengas un problema que el particionamiento pueda resolver.
Antes de tocar una tabla en producción, mide. Revisa los índices. Analiza EXPLAIN y EXPLAIN ANALYZE. Diseña el particionamiento y vuelve a medir.
Porque en bases de datos, como casi siempre, optimizar a ojo es una forma estupenda de optimizar hacia ninguna parte.
Visitas: 17
Automation & Data Specialist | Web Development | Data Processing & Integration